Data Science Artisanale
Modéliser
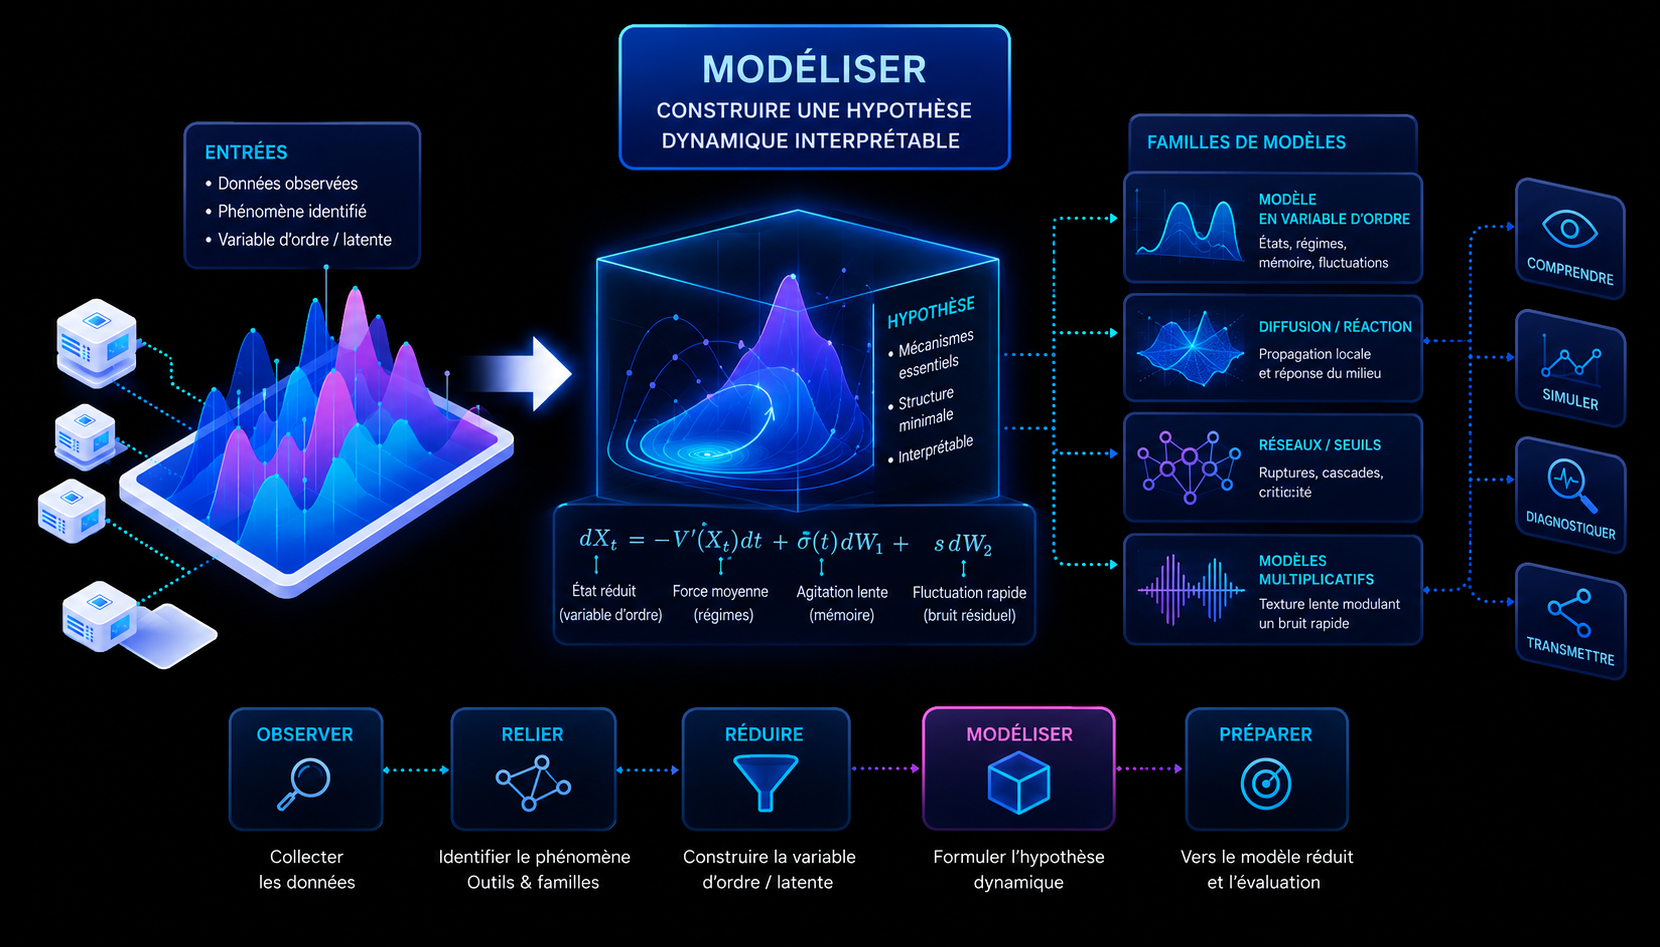
Modéliser, ce n’est pas plaquer une équation sur les données. C’est traduire une hypothèse sur le système en une structure dynamique interprétable. Un bon modèle réduit conserve peu de paramètres, mais chacun d’eux doit avoir un sens. Il doit expliquer les régimes, les fluctuations, les transitions ou les propagations observées, et produire des conséquences testables.
Modéliser : construire une hypothèse dynamique interprétable
Modéliser est le moment où la méthode passe de la compréhension qualitative à une forme opératoire. Après avoir observé les données, relié le phénomène à une famille de systèmes complexes et identifié une variable d’ordre, il devient possible de construire un modèle.
Mais modéliser ne signifie pas choisir mécaniquement un algorithme. Dans cette approche, le modèle est d’abord une hypothèse organisée sur le fonctionnement du système.
Il doit répondre à une question simple :
Quelle structure minimale permet de représenter le phénomène dominant sans perdre son sens ?
Un système complexe peut être extrêmement riche, mais son comportement collectif peut parfois être décrit par quelques mécanismes essentiels. Il peut être attiré vers certains régimes. Il peut garder la mémoire de ses perturbations. Il peut être traversé par des fluctuations rapides. Il peut diffuser localement une contrainte. Il peut réagir selon une capacité de résistance. Il peut approcher un seuil. Il peut basculer.
Modéliser consiste à organiser ces mécanismes dans une forme lisible.
Dans un système stationnaire, traversé par des fluctuations, on pourra chercher un modèle en variable d’ordre :
dXt=−V′(Xt)dt+σ(t)dW1+sdW2
Cette équation dit beaucoup de choses avec peu de termes. La variable X représente l’état réduit du système. Le potentiel V représente les régimes préférentiels. Le terme −V′(Xt) représente la force moyenne qui ramène le système vers ces régimes. Le terme σ(t)dW1\sigma(t)dW_1σ(t)dW1 représente une agitation lente, variable, éventuellement porteuse de mémoire. Le terme sdW2s dW_2sdW2 représente une fluctuation rapide ou résiduelle.
Dans un système en transformation, le modèle pourra prendre une autre forme. Si le phénomène principal est la propagation d’une contrainte ou d’un changement, une équation de diffusion/réaction devient naturelle. La diffusion représente le passage d’une perturbation d’un point à un autre. La réaction représente la réponse locale du milieu. Dans une organisation, par exemple, cela peut traduire la manière dont une pression se diffuse entre équipes, puis rencontre localement des résistances, des ressources ou des capacités d’adaptation.
Dans un système soumis à des seuils, à des ruptures ou à des cascades, un modèle de réseau, de percolation ou de criticité peut devenir plus pertinent. Dans un signal intermittent, comme le fouillis de mer radar, un modèle multiplicatif peut être mieux adapté : un bruit rapide est modulé par une texture lente porteuse de la géométrie, des pentes, du masquage ou de la rugosité.
Il n’existe donc pas un seul modèle universel. Il existe une famille de modèles possibles, choisie en fonction du phénomène dominant.
C’est pourquoi la modélisation doit rester fidèle aux étapes précédentes. Le modèle doit venir de l’observation. Il doit être éclairé par la cartographie des systèmes complexes. Il doit s’appuyer sur une variable d’ordre ou une variable latente pertinente. Et il doit rester interprétable.
Un modèle réduit n’est pas un modèle pauvre. C’est un modèle qui cherche à conserver les mécanismes essentiels. Sa valeur ne tient pas seulement à sa performance prédictive, mais à sa capacité à expliquer, à simuler, à diagnostiquer et à transmettre.
Cette étape prolonge la méthode empirique classique. Dans l’esprit de De Groot, toute démarche scientifique commence par un historique du problème, une observation rigoureuse, puis une induction : à partir de ce qui est observé, on cherche l’hypothèse la plus plausible sur le mécanisme qui produit les phénomènes.
Appliquée à la data science, cette démarche conduit à considérer les données non comme une matière brute à faire entrer immédiatement dans un algorithme, mais comme les traces visibles d’un système complexe. Avant de modéliser, il faut donc comprendre le domaine, explorer les travaux existants, identifier les systèmes apparentés, choisir les bons points de mesure et préciser les conditions dans lesquelles les données ont été produites.
L’observation devient alors une véritable écoute du système. Elle cherche les régimes, les ruptures, les cycles, les corrélations longues, les événements extrêmes, les interfaces actives et les échelles pertinentes. Elle distingue ce qui est directement mesuré de ce qui est seulement révélé indirectement : variable latente, texture, tension, confiance, résilience ou état interne.
À la fin de cette étape, le but n’est pas encore de construire le modèle définitif. Il est de formuler une hypothèse structurante : quel est le phénomène dominant ? Quelle grandeur pourrait le représenter ? Quelle variable d’ordre peut concentrer le comportement collectif ? Et vers quelle famille de modèles faut-il orienter la suite ?
Observer, dans cette méthode, c’est donc déjà commencer à penser le modèle, sans encore l’imposer.
Les grandes familles de modèles possibles
|
Phénomène dominant
|
Famille de modèles
|
Ce que le modèle permet de comprendre
|
|---|---|---|
|
Régimes stables / attracteurs
|
Potentiel, équation différentielle stochastique
|
États préférentiels, forces de rappel, barrières, basculements.
|
|
Mémoire longue / volatilité persistante
|
Processus à mémoire, bruit fractionnaire, volatilité stochastique
|
Persistance des perturbations, alternance calme/crise, corrélations lentes.
|
|
Propagation / transformation
|
Diffusion/réaction
|
Propagation d’une contrainte, réponse locale, résilience, transformation.
|
|
Événements extrêmes / queues lourdes
|
Modèles multiplicatifs, lois de puissance, modèles de texture
|
Intermittence, glints, crises, événements rares mais structurants.
|
|
Transitions / bifurcations
|
Systèmes dynamiques non linéaires
|
Changement qualitatif de comportement, perte de stabilité, basculement.
|
|
Réseaux / contagion / dépendances
|
Graphes, percolation, automates cellulaires
|
Propagation, seuils de connectivité, cascades, vulnérabilités.
|
|
Interfaces / formes / croissance
|
Modèles fractals, lois d’échelle, théorie constructale
|
Morphogenèse, rugosité, structures ramifiées, flux.
|
|
Compétition / choix collectifs
|
Lotka-Volterra, théorie des jeux, modèles d’attracteurs
|
Équilibres, dominance, coexistence, convergence ou instabilité.
|
Les critères d’un bon modèle réduit
Un bon modèle réduit doit :
|
Critère
|
Signification
|
|---|---|
|
Être issu de l’observation
|
Il doit répondre à un phénomène réellement observé dans les données.
|
|
Être relié à une famille de phénomènes
|
Il doit s’inscrire dans une cartographie : mémoire, diffusion, potentiel, percolation, fractalité, etc.
|
|
Reposer sur une variable pertinente
|
La variable d’ordre ou latente doit porter le comportement collectif.
|
|
Avoir peu de paramètres
|
La simplicité est recherchée, mais pas au prix de la perte du phénomène essentiel.
|
|
Donner un sens à chaque terme
|
Chaque terme doit correspondre à un mécanisme physique, systémique ou métier.
|
|
Produire des conséquences testables
|
Le modèle doit conduire à des signatures observables : régimes, distributions, seuils, transitions.
|
|
Être calibrable
|
Ses paramètres doivent pouvoir être estimés ou encadrés par les données.
|
Sortie attendue de la page “Modéliser”
À la fin de la page Modéliser, le lecteur doit comprendre que le modèle est une construction progressive, issue des étapes précédentes.
La sortie attendue est la suivante :
|
Sortie
|
Description
|
|---|---|
|
Une structure de modèle
|
Potentiel, SDE, diffusion/réaction, réseau, fractalité, modèle multiplicatif, etc.
|
|
Des paramètres interprétables
|
Chaque paramètre possède un sens physique, systémique ou métier.
|
|
Des conséquences testables
|
Le modèle produit des signatures observables dans les données.
|
Cette dernière sortie prépare naturellement la page suivante : Interpréter.
Tableau de méthode
|
Méthode de De Groot
|
Rubrique
|
Question centrale
|
Contenu
|
|---|---|---|---|
|
Déduction
|
Choisir la forme du modèle
|
Quelle structure dynamique correspond au phénomène identifié ?
|
Potentiel, équation différentielle stochastique, diffusion/réaction, réseau, percolation, modèle multiplicatif, modèle fractal, modèle S/R.
|
|
Déduction
|
Traduire l’hypothèse en équation
|
Comment écrire mathématiquement l’hypothèse inductive ?
|
Transformer l’idée issue de l’observation en relation formelle : dérive, mémoire, bruit, diffusion, réaction, seuil, interaction.
|
|
Déduction → Évaluation
|
Donner un sens à chaque terme
|
Que représente chaque composante du modèle ?
|
Variable d’ordre, potentiel, force de rappel, volatilité, bruit rapide, texture, résistance, sollicitation, propagation, interaction locale.
|
|
Évaluation
|
Identifier les paramètres significatifs
|
Quels paramètres doivent être estimés et interprétés ?
|
Paramètres de stabilité, intensité du bruit, mémoire longue, exposants d’échelle, seuils, coefficients de diffusion, paramètres de résistance.
|
|
Déduction → Tests
|
Déduire les conséquences observables
|
Si le modèle est juste, que doit-on observer ?
|
Régimes, distributions, autocorrélations, queues lourdes, transitions, élargissement spectral, propagation, seuils critiques.
|
|
Tests
|
Calibrer le modèle sur les données
|
Comment ajuster le modèle sans perdre son sens ?
|
Estimation des paramètres, comparaison aux données, validation statistique, robustesse, incertitude, sensibilité.
|
|
Tests → Évaluation
|
Comparer plusieurs modèles candidats
|
Quel modèle explique le mieux avec le moins de paramètres ?
|
Comparaison entre modèles empiriques, modèles physiques, modèles statistiques, modèles réduits, modèles plus complexes.
|
|
Évaluation
|
Construire un simulateur
|
Peut-on transformer le modèle en expérience numérique ?
|
Simulation de trajectoires, génération de signaux, scénarios, jumeau numérique réduit, test de configurations limites.
|
|
Application
|
Préparer l’usage décisionnel
|
Que permet le modèle pour comprendre, anticiper ou agir ?
|
Diagnostic, prédiction, surveillance, détection de seuils, scénarios, aide à la décision, formation.
|
Commentaire du tableau
La page “Modéliser” commence dans l’étape de déduction de De Groot. Une fois l’hypothèse inductive formulée, il faut en tirer une structure. Si l’on suppose que le système possède des régimes stables, alors un modèle de potentiel devient naturel. Si l’on suppose que le phénomène se propage dans un milieu, alors un modèle diffusion/réaction devient pertinent. Si l’on suppose que des événements extrêmes émergent d’une modulation lente d’un bruit rapide, alors un modèle multiplicatif devient cohérent.
La modélisation consiste donc à traduire une hypothèse en forme dynamique.
La deuxième étape consiste à écrire cette hypothèse sous forme d’équation, de réseau, de simulateur ou de schéma génératif. Ce passage est essentiel : le modèle n’est pas une décoration mathématique, il est la formalisation d’une idée.
La troisième étape impose une exigence forte : chaque terme du modèle doit avoir un sens. C’est l’un des points centraux de votre méthode. Une dérive n’est pas seulement un coefficient ; elle représente une force moyenne. Un potentiel représente un paysage de régimes. Une diffusion représente une propagation. Une réaction représente une réponse locale. Un bruit représente les degrés de liberté non explicités. Une texture représente une modulation lente. Une résistance représente une capacité d’absorption ou de résilience.
Ensuite vient l’identification des paramètres. Là encore, votre approche se distingue d’un ajustement purement statistique. Les paramètres doivent être estimés, mais aussi interprétés. Ils doivent dire quelque chose du système réel.
L’étape suivante est déductive : si le modèle est pertinent, il doit produire des conséquences observables. Il doit expliquer des distributions, des régimes, des queues lourdes, des autocorrélations, des transitions ou des comportements critiques. Le modèle doit donc être testable.
La calibration permet ensuite de confronter le modèle aux données. Mais cette calibration ne doit pas détruire l’interprétabilité. Il ne s’agit pas de multiplier les paramètres pour améliorer artificiellement l’ajustement. Il s’agit de chercher le meilleur compromis entre simplicité, robustesse et pouvoir explicatif.
Enfin, la modélisation peut conduire à un simulateur. Dans votre démarche, le simulateur est très important : il transforme le modèle en expérience numérique. Il permet d’explorer des scénarios, de tester des conditions limites, de comprendre les régimes et d’éclairer la décision.
Ressources & Documents d'étude
Pour prolonger la lecture et explorer les fondements théoriques, épistémologiques et psychologiques du geste d’observation, vous pouvez consulter les essais et travaux de recherche associés.
Ce chapitre propose une vision unifiée des systèmes complexes (comme la turbulence hydrodynamique ou les marchés financiers) à travers la réduction de leur dynamique vers une forme canonique universelle.
Lorsqu'on sélectionne une variable d'ordre pertinente pour résumer un système de grande dimension, sa dynamique réduite se structure autour de trois composantes fondamentales :
Une composante structurante (Structure) : Un potentiel effectif (souvent quartique) qui organise les régimes de stabilité, les attracteurs et les transitions critiques (bifurcations).
Une composante rémanente (Histoire) : Une intensité latente à mémoire longue (volatilité stochastique / intermittence) qui traduit la rétroaction différée des degrés de liberté rapides qui ont été éliminés.
Une composante fluctuante (Fluctuation) : Un bruit effectif résiduel représentant l'agitation rapide et immédiate sans mémoire.
En combinant ces dimensions (notamment testées sur les données du CAC 40), le texte démontre que la dynamique observable est la synthèse de la structure, de l'histoire et des fluctuations, offrant un cadre mathématique unificateur et minimal pour la physique des données.
Ce texte propose un modèle réduit, pédagogique et transdisciplinaire conçu pour comprendre et piloter les transformations au sein des systèmes complexes. Il repose sur une grammaire commune à de multiples domaines (risque cyclonique, crédit, fatigue des matériaux, invasion tumorale) : un système subit une sollicitation locale ($S$) face à une capacité de résistance ($R$) ; lorsque le seuil $\frac{S}{R} > 1$ est franchi, une transformation s'enclenche, modifie le voisinage et se propage (cascades, fronts, avalanches).
Le document s'articule autour de trois axes majeurs :
Une méthode descendante de Data Science : Contrairement à l'approche classique guidée par les données, cette méthode part de la finalité (le pourquoi) et du système d'action pour construire un modèle intelligible et sobre en paramètres. L'Analyse Exploratoire des Données (EDA) n'intervient qu'en fin de chaîne pour confronter et calibrer le modèle.
Des formulations physiques et stochastiques : Le modèle traduit mathématiquement ces comportements via des équations de diffusion-réaction (continuum spatial de la transformation), des modèles d'Ising (systèmes binaires et transitions de phase) ou des approches de premier passage (Fokker-Planck pour la marge de solvabilité dans le risque de crédit).
Une méthode d'analyse rigoureuse : L'étude de ces dynamiques suit une trajectoire classique allant de la recherche des états homogènes et de leur stabilité linéaire, jusqu'à l'analyse des fronts d'ondes progressives et des seuils de nucléation.
En combinant une approche temporelle globale (modèles EDO à mémoire et potentiel) et une approche spatio-temporelle distribuée (modèles S/R de croissance et résilience), ce cadre offre une structure unifiée pour appréhender la vulnérabilité et la morphogenèse des systèmes complexes.
La data science face aux défis des systèmes complexes
Face aux nouveaux enjeux planétaires (écologie, climat, astrophysique), la science moderne est confrontée à des flux de données colossaux qui nécessitent une exploitation intelligente. Si l'apprentissage automatique a déjà permis des découvertes majeures en physique des particules et en astronomie, ses applications restent encore trop rares et limitées à quelques secteurs.
Casuistique des problèmes de data science selon les régimes du système, les grandes fonctions analytiques et le rôle des bifurcations
Ce texte propose d'organiser la data science non plus seulement par ses méthodes algorithmiques, mais en croisant le statut dynamique du système et la finalité analytique de la question posée.
Cette casuistique s'articule autour de trois piliers fondamentaux :
Les trois régimes dynamiques : Le système peut se trouver en régime permanent (le fonctionnement est stable et régulier), en régime transitoire (le système approche d'un seuil ou d'une rupture), ou en transformation adaptative sous contrainte (le système se reconfigure progressivement).
Les quatre finalités analytiques : La question posée aux données traverse ces régimes pour effectuer un travail de description/structure, de prédiction continue, de décision/allocation, ou de causalité/mécanisme.
Le rôle des bifurcations et modèles réduits : Les bifurcations (selle-nœud, transcritique, fourche, Hopf) ne résument pas toute la data science, mais fournissent une bibliothèque de formes canoniques pour comprendre les changements qualitatifs de la dynamique dans les régimes transitoires.
Pour traduire mathématiquement ces comportements, deux grands types de modèles réduits et transdisciplinaires sont mobilisés :
Le modèle EDO (Équation Différentielle Ordinaire) : Écrit sous forme de potentiel, de bruit et de volatilité lente, il sert de langage commun pour relier le régime permanent (fluctuations autour d'un attracteur) et les transitoires (franchissement de barrière ou déformation du paysage). Ce modèle s'enrichit par l'introduction d'une variable lente de milieu couplée à la variable d'ordre macroscopique, créant ainsi une mémoire d'état (variable explicite) ou une mémoire de structure (paramètres du potentiel dépendants du milieu).
Le modèle S/R (Sollicitation / Résilience) : Il intervient de façon complémentaire pour le troisième régime (transformation adaptative), là où les phénomènes sont distribués dans l'espace ou sur réseau, permettant de modéliser la propagation de contraintes, les fronts et la morphogenèse.
La data science face aux défis des systèmes complexes
Face aux nouveaux enjeux planétaires (écologie, climat, astrophysique), la science moderne est confrontée à des flux de données colossaux qui nécessitent une exploitation intelligente. Si l'apprentissage automatique a déjà permis des découvertes majeures en physique des particules et en astronomie, ses applications restent encore trop rares et limitées à quelques secteurs.
Casuistique des problèmes de data science selon les régimes du système, les grandes fonctions analytiques et le rôle des bifurcations
Ce texte propose d'organiser la data science non plus seulement par ses méthodes algorithmiques, mais en croisant le statut dynamique du système et la finalité analytique de la question posée.
Cette casuistique s'articule autour de trois piliers fondamentaux :
Les trois régimes dynamiques : Le système peut se trouver en régime permanent (le fonctionnement est stable et régulier), en régime transitoire (le système approche d'un seuil ou d'une rupture), ou en transformation adaptative sous contrainte (le système se reconfigure progressivement).
Les quatre finalités analytiques : La question posée aux données traverse ces régimes pour effectuer un travail de description/structure, de prédiction continue, de décision/allocation, ou de causalité/mécanisme.
Le rôle des bifurcations et modèles réduits : Les bifurcations (selle-nœud, transcritique, fourche, Hopf) ne résument pas toute la data science, mais fournissent une bibliothèque de formes canoniques pour comprendre les changements qualitatifs de la dynamique dans les régimes transitoires.
Pour traduire mathématiquement ces comportements, deux grands types de modèles réduits et transdisciplinaires sont mobilisés :
Le modèle EDO (Équation Différentielle Ordinaire) : Écrit sous forme de potentiel, de bruit et de volatilité lente, il sert de langage commun pour relier le régime permanent (fluctuations autour d'un attracteur) et les transitoires (franchissement de barrière ou déformation du paysage). Ce modèle s'enrichit par l'introduction d'une variable lente de milieu couplée à la variable d'ordre macroscopique, créant ainsi une mémoire d'état (variable explicite) ou une mémoire de structure (paramètres du potentiel dépendants du milieu).
Ce document propose une méthode quantitative pour évaluer la complexité d'un système à partir d'une variable d'ordre $X(t)$, une grandeur macroscopique capable de condenser son comportement collectif.
L'approche repose sur l'articulation de quatre concepts clés :
L'EDO comme modèle réduit : La dynamique de la variable d'ordre est modélisée par une équation différentielle stochastique guidée par un paysage de potentiel $V(X)$ (qui représente l'énergie libre effective et structure les attracteurs) et soumise à des fluctuations.
De la trajectoire à la distribution : L'observation à long terme de la variable d'ordre permet de construire sa densité de probabilité $p(X)$. Le potentiel effectif y est directement lié par la relation $V(X) = -\ln p(X)$.
L'Entropie de Shannon comme mesure de complexité ($C(X) = H(X)$) : Elle quantifie l'incertitude et la diversité statistique des états réellement visités par le système. En combinant les formules, l'entropie devient la moyenne du potentiel exploré ($H(X) = \sum p_i V_i$) : la complexité est donc le potentiel informationnel moyen exploré par le système.
Comparaison des potentiels (Quadratique vs Quartique) :
Potentiel quadratique : Le paysage ne possède qu'une seule vallée (un seul régime stable) ; la distribution est unimodale et l'entropie reste modérée, principalement liée à la largeur des fluctuations.
Potentiel quartique bistable : Le paysage possède deux vallées séparées par une barrière (deux régimes stables). Si le bruit permet au système de visiter et de basculer entre les deux régimes, la distribution devient bimodale. L'entropie augmente alors d'environ $\ln 2$ car une incertitude majeure s'ajoute : le choix du régime occupé.
Formule conceptuelle à retenir :
Potentiel = forme du paysage ; Probabilité = occupation du paysage ; Entropie = richesse de cette occupation.
Ce texte apporte une justification mathématique et géométrique à l’utilisation d’une équation différentielle stochastique (EDO) réduite pour modéliser un système complexe de grande dimension ($Z_t$) à travers une unique variable d'ordre scalaire ($X_t = G(Z_t)$).
L'analyse démontre que l'EDO canonique :
n'est pas une simple hypothèse empirique, mais la forme naturelle d'une fermeture stochastique minimale. Elle repose sur trois concepts géométriques et physiques fondamentaux :
La projection par la formule d'Ito : En appliquant la formule d'Ito à la dynamique vectorielle de $Z_t$ (composée d'une partie gradientielle $-\nabla U$ et d'une partie non conservative/rotationnelle $R$), on obtient la dérive instantanée de la variable d'ordre, corrigée par la courbure de la fonction de projection $G$.
Le potentiel effectif $V(X)$ : Il décrit la géographie statistique visible des régimes du système (attracteurs, barrières). Ce potentiel reduced ($V_{eff}(X) = -\log p(X)$) s'apparente à une énergie libre issue de l'intégration des états cachés compatibles avec une même valeur de $X_t$.
Le rôle de la composante tangentielle et l'émergence de la mémoire : Les forces de la dynamique complète qui sont tangentielles aux surfaces de projection ($G(Z)=x$) n'altèrent pas instantanément la valeur de $X_t$. Néanmoins, elles déplacent le système dans l'espace caché, modifiant ainsi ses conditions d’évolution future. L'élimination de ces variables cachées brise le caractère markovien du système réduit et fait naturellement réapparaître cette dynamique tangentielle sous forme de mémoire, de bruit coloré ou de volatilité lente ($\sigma(t)$).
Le formalisme de Mori-Zwanzig vient confirmer cette structure en montrant que toute réduction d'un système de grande dimension génère inévitablement un terme markovien (le potentiel), un terme de mémoire et un bruit orthogonal (les fluctuations).